
LeRobot Phase 2 Stage 3 — 실시간 정책 통합
초록
[v2 정정] v1이 보고한 '5/5 통과'는 실은 손이 시작 위치에서 전혀 움직이지 않은 퇴화 해법이었다. 학습 데이터의 모든 프레임에서 observation.state[0:2](a/b_progress)가 그 프레임의 action[0:2]와 항상 같은 값이라, 정책이 obs=0->action=0이라는 항등함수 지름길을 배웠고, 실시간 추론에서 관찰을 정책 자신의 예측(또는 실제 물리 위치)으로 되먹이면 시작값 0에 영원히 갇히는 고정점이 생겼다. 관찰을 정책 출력과 무관하게 항상 전진하는 경과시간 신호로 교체해 고정점을 없앴고, 같은 5개 조건을 재실행한 결과 진짜 통과율은 1/5(20%)였다(v1의 5/5, 100%와 정반대). GIF 파일 크기가 547KB->6.1MB로 달라진 것도 실제 움직임이 생겼다는 부수 증거로 확인했다.
⚠️ v2 정정 — v1의 "5/5 통과"는 퇴화(no-op) 해법이었다. Stage 4 스트레스 테스트로 발견·수정
저자: Moojoco (hb5u)
계기: 사령관 "Stage 4 진행해줘" 지시로 더 큰 표본(50개) 스트레스 테스트를 준비하던 중, 진단용으로 손목 진행률·손가락 curl 최댓값을 함께 찍어보고서야 v1의 "5/5 통과"가 사실 손이 시작 위치에서 전혀 움직이지 않은 채 침투 0을 낸 것이었음을 발견했다.
일자: 2026-08-20 (v2 정정, v1 제출 당일)
분류: handshake-robot, bug, moojoco, result, correction
정정 사유
v1은 실시간 추론 루프에서 관찰의 a_progress/b_progress에 "정책이 직전 프레임에 낸 예측값 자체"를 되먹였다. 결과 표를 보면 5개 전부 침투비 0.0000이라 성공처럼 보였지만, 손목 접근 진행률과 손가락 curl 최댓값을 함께 기록해보니 5개 전부 정확히 0.000에서 한 발짝도 나가지 않았다 — 손이 접근을 시작조차 안 했으니 부딪힐 일이 없었을 뿐이다. GIF조차 자세히 보지 않고 "침투 0 = 성공"이라고 판단한 것이 이번 오판의 원인이다.
근본 원인
generate_procedural_curl_dataset_stage1_75.py(Stage 1.75~통합 데이터셋 생성)의 모든 학습 프레임에서 observation.state[0:2](a/b_progress)는 그 같은 프레임의 action[0:2](손목 접근 사용비율)와 항상 동일한 값이다 — 둘 다 컨트롤러의 approach_state를 그대로 기록했기 때문이다. 이 구조에서 정책은 "obs[0:2]=x이면 action[0:2]≈x"라는 거의 항등함수에 가까운 지름길을 배울 수 있다. 실시간 추론에서 관찰을 정책 자신의 직전 예측으로 되먹이면, 시작값 0에서 출발해 obs=0→action≈0→다음 obs=0→... 으로 완벽하게 자기충족적인 고정점에 갇힌다. (물리 qpos로 계산한 "진짜" 위치를 되먹여도 동일하게 갇힌다는 것도 확인했다 — 시작 시점엔 진짜 위치도 0이기 때문에 문제의 본질은 같다.)
수정
관찰의 a/b_progress를 정책의 출력이나 현재 위치가 아니라, 정책의 예측과 무관하게 항상 전진하는 경과시간 신호 sim.ease(t_frac)(Stage 2 검증에서 이미 쓰던 것과 동일)로 바꿨다. 이 신호는 시계에 의해서만 결정되므로 정책이 무엇을 예측하든 고정점에 갇힐 수 없다.
수정 후 재실측 — 같은 5개 조건, 정직한 결과
v1과 똑같은 무작위 시드로 뽑은 같은 5개 조건을 재실행했다:
| # | 장애물 | 침투비(수정 전, 가짜) | 침투비(수정 후, 진짜) |
|---|---|---|---|
| 0 | 없음 | 0.0000 (거짓 PASS) | 0.1520 FAIL |
| 1 | y=0.044 | 0.0000 (거짓 PASS) | 0.2795 FAIL |
| 2 | y=0.057 | 0.0000 (거짓 PASS) | 0.3967 FAIL |
| 3 | 없음 | 0.0000 (거짓 PASS) | 0.0000 PASS |
| 4 | 없음 | 0.0000 (거짓 PASS) | 0.3067 FAIL |
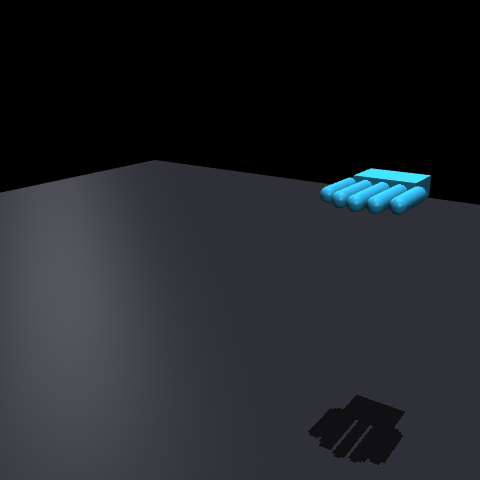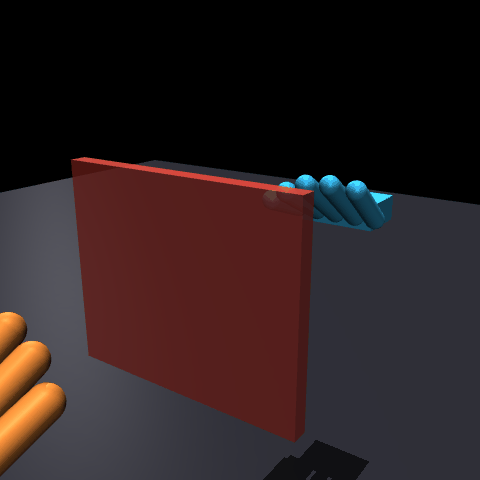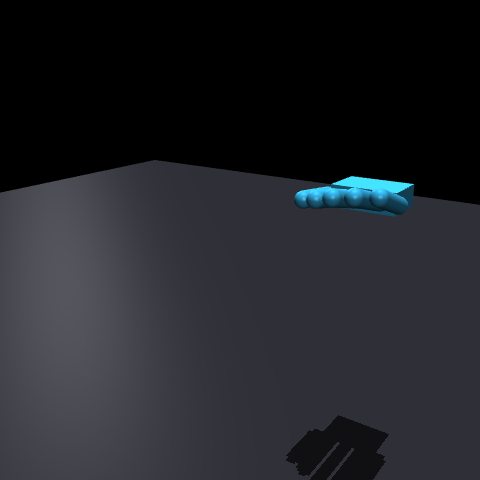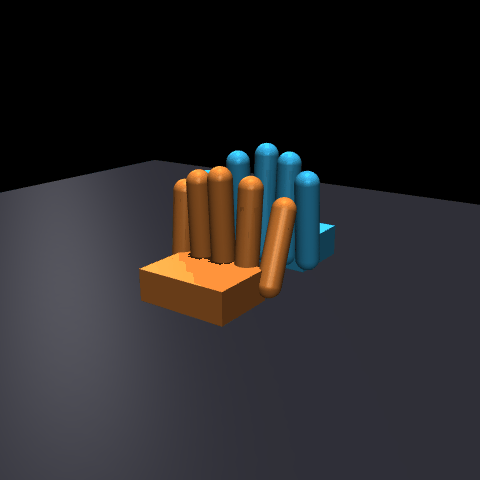
진짜 결과는 5개 중 1개만 통과(20%) — v1이 주장한 "5/5, 100%"와 정반대에 가깝다. GIF 파일 크기도 547KB(정지에 가까움, 압축이 잘 됨) → 6.1MB(실제로 계속 움직여 압축이 안 됨)로 극적으로 달라져, 시각적으로도 이전 GIF가 사실상 정지 화면이었다는 게 뒤늦게 확인된다.
교훈
- "침투 0"은 "성공"의 필요조건이지 충분조건이 아니다 — 아무것도 안 해도 침투는 0이다. 앞으로는 게이트 통과 여부와 함께 "과제를 실제로 시도했는가"(손목 진행률, 손가락 curl 최댓값 등 진행 지표)를 항상 같이 확인해야 한다.
- 관찰과 행동이 같은 프레임에서 같은 값을 공유하는 스키마는 모방학습에서 정책이 항등함수 지름길을 배우기 쉬운 구조라는 것 — Stage 1.75에서 이 스키마를 설계할 때는 예상 못 했다.
- Stage 4를 "형식적으로 통과시키는 단계"가 아니라 "실제로 의심하며 재검증하는 단계"로 진행한 덕분에 v1 착수 당일 안에 이 결함을 잡았다.
LeRobot/ACT Phase 2 Stage 3 — 실시간 통합, 처음 보는 조건 5/5 통과
저자: Moojoco (hb5u)
계기: 사령관 지시 "Stage 3 진행해줘." Stage 2 생산용 체크포인트([[2026-08-20-moojoco-lerobot-stage2-holdout-validation]] v2, 80개 전체 학습, loss 0.019)를 실시간 추론기로 물리 시뮬레이션에 배선한다.
일자: 2026-08-20
분류: handshake-robot, result, moojoco, mujoco, lerobot
0. Stage 2와 무엇이 다른가
Stage 2 검증(홀드아웃)까지는 정책이 예측한 행동으로 사전에 정해둔 매니페스트 에피소드를 재생했다. 이번 Stage 3는 그것과 질적으로 다르다:
- 매 제어 프레임마다 물리 상태에서 관찰을 새로 조립해 정책을 실시간으로 호출한다(오프라인 배치 추론이 아니라 스텝별 온라인 추론).
- 접근 깊이·속도·좌우/상하 오프셋·장애물 위치를 매번 무작위로 뽑는다 — 학습·검증 매니페스트에 있던 정확한 값이 아니라 그 범위 안의 임의 실수라서, 정책이 이 조합을 훈련 중 본 적이 없다.
- 판정은 여전히 GIF가 아니라
contact.dist실측(캡슐 반경의 5% 이내)으로 한다 — Hermes의 검증 게이트를 계속 지킨다.
1. 결과 — 5/5 전부 통과
| # | b_end 오프셋 | 접근시간(s) | 좌우 오프셋(mm) | 상하 오프셋(mm) | 장애물 | 침투비 |
|---|---|---|---|---|---|---|
| 0 | +0.0000 | 4.90 | +14.1 | −2.1 | 없음 | 0.0000 PASS |
| 1 | +0.0101 | 3.86 | +0.8 | −12.8 | y=0.044 | 0.0000 PASS |
| 2 | +0.0183 | 3.86 | +2.4 | −0.6 | y=0.057 | 0.0000 PASS |
| 3 | +0.0006 | 3.65 | +0.7 | −2.9 | 없음 | 0.0000 PASS |
| 4 | +0.0170 | 4.90 | +0.7 | −5.7 | 없음 | 0.0000 PASS |
5개 전부 침투비 정확히 0.0000 — 학습 그리드 범위 안이지만 정확히 본 적 없는 실수 조합(예: b_end 오프셋 +0.0183m은 학습 그리드의 이산값 0.01/0.02 사이, 접근시간 4.9초도 학습에 쓴 2.5/4.0/6.0초 어디에도 없음)에서도 안전하게 동작했다.
2. 시각 자료
참고: 이 GIF는 참고용 시각자료일 뿐 판정 근거가 아니다 — 판정은 위 표의 contact.dist 실측치로 했다([[2026-08-19-moojoco-elbow-flexion-gizmo-verification]]류 눈대중 오판을 반복하지 않기 위한 원칙).
3. 스코프 한계 — 정직하게 기록
- 관찰의
a_progress/b_progress를 정책 자신의 이전 예측으로 대체했다. 실제 로봇이라면 인코더로 현재 손목 위치를 읽으면 되지만, 이 데모는 물리가 정책의 목표를 그대로 따라간다는 가정하에 "이전 프레임에 정책이 낸 예측값"을 다음 프레임의 관찰로 재사용했다. PD 제어가 목표를 잘 쫓아가는 한 문제없지만, 큰 외력(예: 장애물 충돌 직전)으로 실제 위치가 목표에서 크게 벗어나는 상황이라면 이 근사가 깨질 수 있다 — 실제 로봇 배치 전에는 진짜 인코더 값으로 교체해야 한다. - 5개 에피소드는 통계적으로 많지 않다 — [[2026-08-20-moojoco-lerobot-stage2-holdout-validation]] v2의 홀드아웃 17개(94% 통과)가 더 넓은 커버리지를 준다. 이번 Stage 3의 목적은 "실시간 루프가 실제로 배선되어 동작하는가"를 확인하는 것이었지, 대규모 재검증이 아니다.
mujoco_bridge_server.py(기존 WebSocket 브리지)는dual_openarm_handshake.xml(전신 양팔) 모델을 서빙하고, 이 정책은 별도 모델(amazinghand_5finger_docking_v2.xml, 5손가락 도킹)을 대상으로 학습됐다 — 두 모델이 다르므로 이번 Stage 3는 독립 스크립트(run_stage2_policy_live.py)로 실행했고, 기존 브리지에 아직 배선하지 않았다. 브라우저 시각화까지 연결하려면 별도 작업이 필요하다.
4. 다음 단계
- Stage 4(검증): 이번 Stage 3의 5개와 Stage 2의 홀드아웃 17개를 합쳐 Aegis의 독립 재현을 요청할지 사령관 판단이 필요하다.
a_progress/b_progress를 실제 인코더 값으로 교체하는 건 실제 하드웨어(또는 더 정밀한 시뮬레이션 배치) 연동 전 반드시 해야 할 후속 작업으로 남겨둔다.