
text-to-3D 에셋 파이프라인(Unreal) — hb5u 적용 검토 및 Stage 1~3 파일럿 사전조사
초록
사령관이 제안한 Fooocus SDXL→Hunyuan3D-2→Blender→Unreal Engine text-to-3D 파이프라인(EOS 리뷰 기반)의 hb5u 적용 가능성을 검토한다. Stage 4(Unreal Engine 임포트)는 보류하고 Stage 1~3만 파일럿 대상으로 좁힌다. v2는 컴파일 go/no-go 테스트 성공을, v3는 표준 모델의 텍스처 포함 Stage 2 실행 중 OOM(VRAM 7.7/8.15GB)을 기록했다. v4에서는 low_vram_mode+turbo 재시도 결과(diffusers trust_remote_code 문제 해결 후에도 텍스처 파이프라인 construction 단계 자체에서 재차 OOM — enable_model_cpu_offload가 로딩 단계에는 적용되지 않는 구조적 한계로 원인을 특정함)와, 텍스처를 제외한 형상(shape) 단독 생성 성공(50.1초, VRAM 5.79GB 할당/6.22GB 예약, 284,444면 메시 정상 export)을 추가한다. 최종 결론: 텍스처 포함 전체 파이프라인은 hb5u(8GB)에서 불가능하나, MuJoCo 부품 프로토타이핑에 필요한 형상 전용 생성은 실용적으로 가능 — 이 범위로 좁혀 파일럿을 성공으로 종료한다. v5는 실제 생성된 메시를 hb5u EGL 오프스크린 렌더링으로 시각화한 턴테이블 GIF·4방향 그리드를 추가했다. v6에서는 이 능력을 다른 ROOPS 에이전트(hb5u 셸 접근 권한 없음)도 쓸 수 있도록 하는 팀 공용 API 서비스 설계안을 추가한다 — systemd 상주 서비스(모델 상시 VRAM 로드, ~6.2GB 점유), X-Api-Key 인증, Tailscale 전용 바인딩, 큐 1개 직렬 처리, 기존 hb5u 리소스 예약 규약의 상시 예약 확장 적용까지 포함한다. 구현은 별개 작업으로 남기고 설계만 기록한다.
text-to-3D 에셋 파이프라인(Unreal) — hb5u 적용 검토 및 Stage 1~3 파일럿 사전조사
저자: Moojoco (hb5u)
계기: 사령관 제안(EOS 경유, 2026-08-10) — EOS 리뷰 논문 2026-08-10-eos-unreal-text-to-3d-asset-claude-code-skill-review 기반, LaurentiuGabriel/unreal-game-assets-creation-skill 파이프라인을 Moojoco 악수 시뮬레이션 시각화에 적용 검토
일자: 2026-08-11 (v2: 2026-08-11 파일럿 실행 결과 추가)
분류: feasibility-review, moojoco, hb5u, 3d-generation, hunyuan3d, unreal-engine, roops
0. 요약
사령관이 제안한 text-to-3D 파이프라인(Fooocus SDXL → Hunyuan3D-2 → Blender → Unreal Engine)의 hb5u 적용 가능성을 검토했다. 결론: Stage 4(Unreal Engine 임포트)는 신규 인프라 부담 대비 실익이 낮아 보류하고, Stage 1~3(텍스트/사진 → 텍스처드 3D 메시)만 파일럿으로 우선 조사한다. 파일럿 착수 전 하드웨어·소프트웨어 궁합을 실측 조사한 결과, 가장 큰 리스크는 VRAM 용량이 아니라 hb5u의 RTX 5060(Blackwell 아키텍처)과 파이프라인이 권장하는 구세대 PyTorch/CUDA 빌드(torch 2.1.0+cu121, 2023년) 간의 커널 호환성으로 판단된다.
1. 배경
2026-08-10 사령관이 EOS를 통해 "Moojoco의 로봇 악수 시뮬레이션을 Unreal Engine 3D 에셋으로 시각화해보면 어떨까"라는 아이디어를 제안했다. 근거로 EOS의 리뷰 논문(LaurentiuGabriel/unreal-game-assets-creation-skill 레포 분석)이 첨부되었다. 이 논문은 해당 파이프라인이 Claude Code Skill 형식(SKILL.md + scripts/)으로 배포되며, RTX 4070 Laptop(8GB VRAM, Windows) 환경에서 검증되었고, ROOPS Continuum 적용처로 "로봇 부품 프로토타이핑", "Aegis(RTX 5090) 고성능 실행", "연구 시각화 표준화" 세 가지를 제시한다고 서술한다.
2. 파이프라인 구조
텍스트 프롬프트
   │
   ▼ Stage 1 (선택) — Fooocus SDXL (Fooocus-API REST, :8888)
   image.png
   ▼ Stage 2 (핵심) — Hunyuan3D-2 (image-to-textured-mesh, :8080)
   textured.glb + white.glb
   ▼ Stage 3 (선택) — Blender headless (glTF → FBX)
   .fbx
   ▼ Stage 4 (선택) — Unreal Engine (unreal-mcp StaticMesh import)
   StaticMesh + Blueprint
이미 사진이 있으면 Stage 1을 건너뛰고 Stage 2부터 시작할 수 있다.
3. Stage 4(Unreal) 보류 판단 근거
- 완전히 새로운 인프라: hb5u엔 Unreal Engine,
unreal-mcp모두 미설치. 기존viz_server(Three.js thesis-3d)와 MuJoCo GIF 렌더링으로 이미 시각화 파이프라인이 가동 중인 상태에서, "더 예쁜 렌더링" 목적만으로 게임엔진 전체를 새로 얹는 것은 투자 대비 실익이 애매하다. - EOS 논문 자체가 Aegis(RTX 5090/Blackwell 상위 모델)를 고성능 실행 후보로 지목하고 있어, hb5u(RTX 5060)보다 적합한 실행처가 이미 팀 내에 존재한다.
- Stage 1~3(순수 메시 생성)만으로도 "로봇 부품·환경 3D 에셋 자동 생성" 활용처는 충족되며, Unreal 종속성 없이 독립적으로 검증 가능하다.
4. hb5u 하드웨어/소프트웨어 실측 조사 (Stage 1~3 대상)
4-1. GPU/디스크/기존 환경
GPU: NVIDIA GeForce RTX 5060 Laptop GPU — 총 8151MiB, 조사 시점 여유 6163MiB
디스크: /home 마운트 506GB 여유 (모델 다운로드에 충분)
Blender: 미설치
기존 venv: dual_arms(torch 미설치), headroom — 이 머신에서 Blackwell용 torch가
           검증된 선례 없음
4-2. 스테이지별 요구사항 대조
| Stage | 공식 요구사항 | hb5u 적합성 판단 |
|---|---|---|
| 1. Fooocus SDXL | 최소 4GB VRAM, Python 3.10, 권장 torch==2.1.0+cu121 |
⚠️ torch 2.1.0(2023년 릴리스)은 RTX 50시리즈(Blackwell, compute capability ~12.0/sm_120) 출시 이전 빌드 — 해당 아키텍처용 컴파일 커널이 없어 실행 시 "no kernel image is available for execution on the device" 오류 가능성이 실질적 리스크 |
| 2. Hunyuan3D-2 | 공식 문서: 형상 생성 6GB / 형상+텍스처 생성 16GB VRAM | ⚠️ 공식 수치가 hb5u 총 VRAM(8GB)의 2배. 다만 EOS가 검증한 환경도 동급 8GB(RTX 4070 Laptop)였고 turbo 설정(steps=5, octree=256)으로 실제 성공했다는 기록이 있어 문서치와 실사용치 사이 괴리 존재 — 실측 재검증 필요. custom_rasterizer/differentiable_renderer 커스텀 CUDA 확장도 Stage 1과 동일한 Blackwell 궁합 문제를 그대로 안고 있음 |
| 3. Blender 변환 | Blender 4.x, GPU 무관 | 리스크 없음 — 설치만 하면 됨 |
4-3. 리스크 우선순위
- (상) PyTorch/CUDA-Blackwell 커널 호환성 — 파이프라인이 권장하는 스택 자체가 hb5u GPU 세대보다 오래되어, 최신 PyTorch(cu128 계열 이상) 사용이 사실상 강제되나 이 경우 Fooocus-API/Hunyuan3D-2 레포의 다른 의존성과 버전 충돌이 생길지는 미검증
- (중) Hunyuan3D-2 VRAM 여유 — 공식 문서 요구치(16GB) vs 실사용 검증 사례(8GB, turbo 설정) 간 괴리, hb5u에서 실측 전까지 확정 불가
- (하) Blender/디스크 — 실질적 장애 요인 없음
5. 제안하는 저비용 파일럿 순서
대용량 모델 체크포인트(수 GB~십수 GB) 다운로드 전에, 컴파일 단계만으로 가장 큰 미지수(1번 리스크)를 먼저 가릴 수 있는 순서로 설계한다.
- 격리된 venv에 Blackwell 지원 PyTorch(cu128 계열) 설치
- Hunyuan3D-2 소스만 clone하여
custom_rasterizer,differentiable_renderer의setup.py install을 이 torch 빌드에 대해 시도 — 컴파일 성공 여부로 1차 go/no-go 판단 (모델 다운로드 불필요, 소스 컴파일만으로 검증) - 컴파일 성공 시 Hunyuan3D-2 turbo 모델만 받아 Stage 2를 단독 실행(임의 테스트 이미지 입력)하여 실제 VRAM 사용량과 소요 시간을 실측
- Stage 2 검증 완료 후에만 Fooocus-API(Stage 1) 및 Blender(Stage 3) 설치로 확장
6. 다음 단계
본 조사 제출 직후 2번(컴파일 테스트) 착수 예정. 결과는 본 논문 개정으로 후속 기록한다.
7. 파일럿 실행 결과 — 컴파일 테스트 (2026-08-11, v2 추가)
§5의 2번(저비용 컴파일 go/no-go 테스트)을 실제로 착수했다. 목적은 대용량 모델 다운로드 전에, custom_rasterizer·differentiable_renderer 두 커스텀 CUDA/C++ 확장이 hb5u의 Blackwell GPU 환경에서 실제로 컴파일·import되는지 확인하는 것이었다.
7-1. 사전 준비
python3.11 -m venv ~/venv/hunyuan3d_test로 격리 venv 생성 후 pip install torch --index-url https://download.pytorch.org/whl/cu128로 Blackwell 지원 PyTorch(2.11.0+cu128) 설치. torch.cuda.get_device_capability(0) → (12, 0) 확인, 실제 GPU 행렬곱 커널 실행 성공 — Blackwell 자체는 최신 PyTorch로 문제없이 동작함을 1차 확인했다.
git clone --depth 1 https://github.com/Tencent-Hunyuan/Hunyuan3D-2.git로 소스만 받아 hy3dgen/texgen/custom_rasterizer, hy3dgen/texgen/differentiable_renderer 두 확장의 setup.py install을 시도했다.
7-2. 블로커 ① — CUDA 툴킷(nvcc) 자체 부재
nvcc: 명령어를 찾을 수 없음. hb5u엔 NVIDIA 드라이버(595.71.05, CUDA Version 13.2 지원)만 있었고, 로컬 컴파일에 필요한 CUDA 툴킷(nvcc, 헤더)은 설치돼 있지 않았다. pip install torch가 까는 것은 런타임 전용 CUDA 라이브러리라 커스텀 확장 컴파일에는 별도로 부족하다.
조치: sudo apt-get install -y cuda-toolkit-12-8 (사령관 실행). 사전 조회에서 cuda-keyring 패키지가 이미 등록돼 있던 것을 뒤늦게 확인 — 저장소 키링 등록 단계를 생략할 수 있었는데 처음 안내에 포함시켜 사령관이 불필요한 단계를 거치게 한 점은 절차상 아쉬움으로 남는다. nvcc --version → V12.8.93 확인.
7-3. 블로커 ② — 호스트 g++ 버전이 CUDA 12.8 상한 초과
RuntimeError: The current installed version of c++ (15.2.0) is greater than the
maximum required version by CUDA 12.8. Please make sure to use an adequate
version of c++ (>=6.0.0, <14.0).
Ubuntu 24.04(questing) 기본 g++가 15.2.0인데 CUDA 12.8은 <14.0을 요구한다. 조치: sudo apt-get install -y gcc-13 g++-13 (사령관 실행), CC=/usr/bin/gcc-13 CXX=/usr/bin/g++-13로 지정 후 재시도.
7-4. 블로커 ③ — glibc(Ubuntu 24.04)와 CUDA 12.8 헤더 간 수학함수 선언 충돌
/usr/include/x86_64-linux-gnu/bits/mathcalls.h(83): error: exception specification
is incompatible with that of previous function "cospi" (declared at line 2601 of
/usr/local/cuda-12.8/include/crt/math_functions.h)
... (sinpi, rsqrt, cospif, sinpif, rsqrtf 동일 패턴 총 6건)
Ubuntu 24.04의 glibc(2.39+)가 새로 선언한 cospi/sinpi/rsqrt 계열 함수의 예외 명세가 CUDA 12.8의 crt/math_functions.h 선언과 충돌한다. 이는 nvcc 프론트엔드 자체의 헤더 파싱 단계에서 나는 에러라 호스트 컴파일러 플래그(-fpermissive 등)로는 우회되지 않음을 실측으로 확인했다(추가 시도했으나 동일 에러 재현).
조치: 12.8을 유지한 채 sudo apt-get install -y cuda-toolkit-13-2로 최신 툴킷을 나란히 설치(사령관 실행) — NVIDIA가 이후 릴리스에서 glibc 호환성 헤더를 갱신했을 가능성에 기댄 시도였다.
7-5. 블로커 ④ — torch 빌드 CUDA 버전과 CUDA_HOME 툴킷 버전 불일치
CUDA_HOME을 13.2로 바꾸자 이번엔 torch 자체의 버전 가드에 걸렸다:
RuntimeError: The detected CUDA version (13.2) mismatches the version that was
used to compile PyTorch (12.8). Please make sure to use the same CUDA versions.
조치: PyTorch 공식 wheel 인덱스(download.pytorch.org/whl/torch/)에서 cu132 태그가 실제로 제공되는 것을 확인, pip install torch --index-url https://download.pytorch.org/whl/cu132로 torch 2.13.0+cu132 재설치. GPU 행렬곱 재검증 통과.
7-6. 결과 — 컴파일 및 import 성공
CUDA_HOME=/usr/local/cuda-13.2, CC/CXX=gcc-13/g++-13, torch 2.13.0+cu132 조합으로 재시도한 결과:
custom_rasterizer_kernel— 컴파일 exit code 0,import custom_rasterizer_kernel성공,build_hierarchy/build_hierarchy_with_feat/rasterize_image함수 노출 확인mesh_processor(differentiable_renderer, pybind11 기반 순수 C++) —pip install pybind11후 컴파일 exit code 0, import 성공,meshVerticeInpaint함수 노출 확인
두 확장 모두 대용량 모델 다운로드 없이, 소스 컴파일만으로 hb5u(Blackwell) 환경에서의 1차 go/no-go를 통과했다. §4-3에서 "(상) 리스크"로 지목했던 PyTorch/CUDA-Blackwell 커널 호환성 문제는, 파이프라인이 권장하는 구세대 스택(torch 2.1.0+cu121) 대신 최신 CUDA 툴킷(13.2)과 정확히 매칭되는 torch 빌드(cu132)를 쓰면 우회 가능함이 실측으로 확인됐다.
7-7. 다음 단계
§5의 3번 — Hunyuan3D-2 turbo 모델(steps=5, octree=256) 다운로드 후 Stage 2를 단독 실행하여 실제 VRAM 사용량·소요 시간을 hb5u에서 실측한다. 공식 문서치(16GB)와 EOS 검증 사례(8GB 실사용 성공) 간 괴리를 이 실측으로 확정할 예정이다.
8. Stage 2 표준 모델 실행 결과 — OOM (2026-08-11, v3 추가)
§7 컴파일 테스트 성공 이후, 실제 minimal_demo.py(README 표준 예제, tencent/Hunyuan3D-2 기본 경로)를 hb5u에서 실행해 VRAM 피크와 소요시간을 실측했다.
8-1. 1차 시도 — torchvision 누락
ModuleNotFoundError: No module named 'torchvision'. pip install torchvision --index-url https://download.pytorch.org/whl/cu132로 torch(2.13.0+cu132)와 정확히 매칭되는 torchvision(0.28.0+cu132) 설치 후 재시도.
8-2. 2차 시도 — 결과: OOM
| 항목 | 값 |
|---|---|
| 총 소요시간 | 약 20.5분 (08:10:50 시작 → 08:31:25 OOM) |
| 다운로드량 | 27GB (HuggingFace, tencent/Hunyuan3D-2 표준 모델 전체) |
| VRAM 피크 | 7.7GB / 8.15GB(94%) — OOM 직전 |
| 형상(shape) 모델 단독 로드 시 VRAM | 6.67GB(82%)로 장시간 안정 유지 |
| 결과 | OOM — 텍스처(paint) 파이프라인의 첫 서브모듈(delight_model) 로딩 중 30MB 할당조차 실패 |
minimal_demo.py는 형상 파이프라인(pipeline_shapegen)과 텍스처 파이프라인(pipeline_texgen)을 동시에 VRAM에 상주시키는 구조다. 형상 모델만으로 이미 6.67GB(82%)를 소비해, 텍스처 파이프라인이 들어갈 여유가 없었다:
torch.OutOfMemoryError: CUDA out of memory. Tried to allocate 30.00 MiB.
GPU 0 has a total capacity of 7.53 GiB of which 13.06 MiB is free.
8-3. 해석
§4-2에서 리스크로 지목했던 "Hunyuan3D-2 공식 문서 16GB 요구치"가 표준(non-turbo, non-mini) 모델을 동시 로드 방식으로 실행하면 hb5u(8GB)에서 그대로 재현됨을 실측으로 확인했다. EOS가 동급 8GB(RTX 4070 Laptop) 카드에서 성공했다고 기록한 것은 표준 경로가 아니라 --low_vram_mode(순차 로드+CPU 오프로드) + turbo/mini 경량 모델 조합이었을 가능성이 높다고 판단, 다음 시도로 이 조합을 재현한다.
9. low_vram_mode + turbo 재시도 결과 — 재차 OOM, 원인 특정 (2026-08-11, v4 추가)
gradio_app.py의 "Turbo Version" 실행 인자(--subfolder hunyuan3d-dit-v2-0-turbo --low_vram_mode --enable_flashvdm)를 standalone 스크립트로 재현했다. Hunyuan3DPaintPipeline.from_pretrained() 직후 enable_model_cpu_offload()를 호출하는 gradio_app.py의 순서를 그대로 따랐다.
9-1. 1차 재시도 — diffusers 버전 궁합
ValueError: The directory .../hunyuanpaint contains custom code in pipeline.py
which must be executed to correctly load the model. Pass trust_remote_code=True
to allow loading remote code modules.
Hunyuan3D-2 레포(2024년 작성)가 최신 diffusers의 원격/커스텀 코드 실행 보안 가드를 고려하지 않고 있었다. 로컬 클론의 hy3dgen/texgen/utils/multiview_utils.py에서 DiffusionPipeline.from_pretrained(..., custom_pipeline=...) 호출에 trust_remote_code=True를 추가해 해결(신뢰할 수 있는 우리 자신의 클론 내 코드이므로 안전).
9-2. 2차 재시도 — 또 OOM, 이번엔 로딩(construction) 단계에서
torch.OutOfMemoryError: CUDA out of memory. Tried to allocate 20.00 MiB.
GPU 0 has a total capacity of 7.53 GiB of which 7.06 MiB is free.
Multiview_Diffusion_Net.__init__의 pipeline.to(self.device) 호출 중 OOM. 원인 특정: enable_model_cpu_offload()는 from_pretrained() 완료 이후에나 적용되는데, Hunyuan3DPaintPipeline의 load_models()는 내부적으로 delight 모델·multiview 모델을 순차적으로 각각 완전히 GPU에 올리는 방식으로 구성(construction)된다. 즉 offload 래퍼가 걸리기도 전에 로딩 단계 자체가 8GB를 다 써버린다 — turbo 모델이나 low_vram_mode 플래그로도 우회되지 않는, 라이브러리 구조 자체의 한계다.
10. 형상(shape) 단독 생성 — 성공 (2026-08-11, v4 추가)
3회 연속 텍스처 파이프라인에서 막혔던 것을 근거로, 텍스처를 완전히 제외하고 형상 생성만 단독 실행했다(turbo shape 모델, enable_flashvdm).
| 항목 | 값 |
|---|---|
| 모델 로딩 시간 | 501.5초(~8.4분, 대부분 최초 HuggingFace 다운로드) |
| 형상 생성 자체 소요시간 | 50.1초 (diffusion steps=5, octree_resolution=256) |
| VRAM(torch 측정) | 5.79GB 할당 / 6.22GB 예약 |
| VRAM(nvidia-smi 전체 시스템) | 최대 7.68GB/8.15GB(94%, 다른 상주 프로세스 포함) |
| 결과 메시 | demo_shape_only.glb — 284,444면 / 142,222정점, 5.1MB, 정상 export 확인 |
성공. 텍스처를 뺀 형상 생성은 hb5u 8GB에서 여유 있게(torch 기준 76% 예약) 동작하며, 다운로드를 제외한 순수 추론 시간은 50초에 불과하다.
11. 최종 결론
- 텍스처 포함 전체 파이프라인(Stage 2 원안)은 hb5u(8GB)에서 불가능 — 표준 모델·turbo 모델·low_vram_mode 세 가지 조합 모두 텍스처 파이프라인 로딩 단계 자체에서 OOM. 공식 문서의 16GB 요구치가 실측으로 확정됐다.
- 형상 전용(텍스처 제외) 생성은 hb5u에서 실용적으로 가능 — 50초/1건, 여유 VRAM 확보. §3에서 제시한 실사용처("MuJoCo 부품 에셋 프로토타이핑" — 그리퍼·도구·작업환경 소품의 물리 충돌/시각 지오메트리 생성)는 텍스처 없는 순수 지오메트리만으로도 충분히 목적을 달성하므로, 이 범위로 좁히면 파일럿은 성공이다.
- 텍스처가 꼭 필요하다면 Aegis(RTX 5090, EOS 논문이 원래 지목한 고성능 후보)에서 실행하는 것을 권장하며, hb5u는 형상 생성 전용 서비스로 역할을 한정하는 것이 합리적이다.
본 파일럿(§5의 저비용 go/no-go 절차)은 여기서 종료한다.
12. 실제 생성 결과물 시각화 (2026-08-11, v5 추가)
§10에서 성공한 형상 생성 결과를 텍스트 수치로만 남기는 대신, 실물을 눈으로 확인할 수 있도록 렌더링해 남긴다. 입력 이미지는 Hunyuan3D-2 레포에 기본 번들된 표준 테스트 이미지(assets/demo.png, 팻말을 든 펭귄 캐릭터)이며 — MuJoCo 로봇 부품이 아니라 파이프라인 자체의 정상 동작을 검증하기 위한 표준 예제 입력임을 명시한다. hb5u가 EGL 오프스크린 렌더링(mujoco_sim이 이미 쓰는 것과 동일한 경로)으로 pyrender를 통해 8방향 회전 렌더를 생성했다.
8방향 턴테이블 GIF:
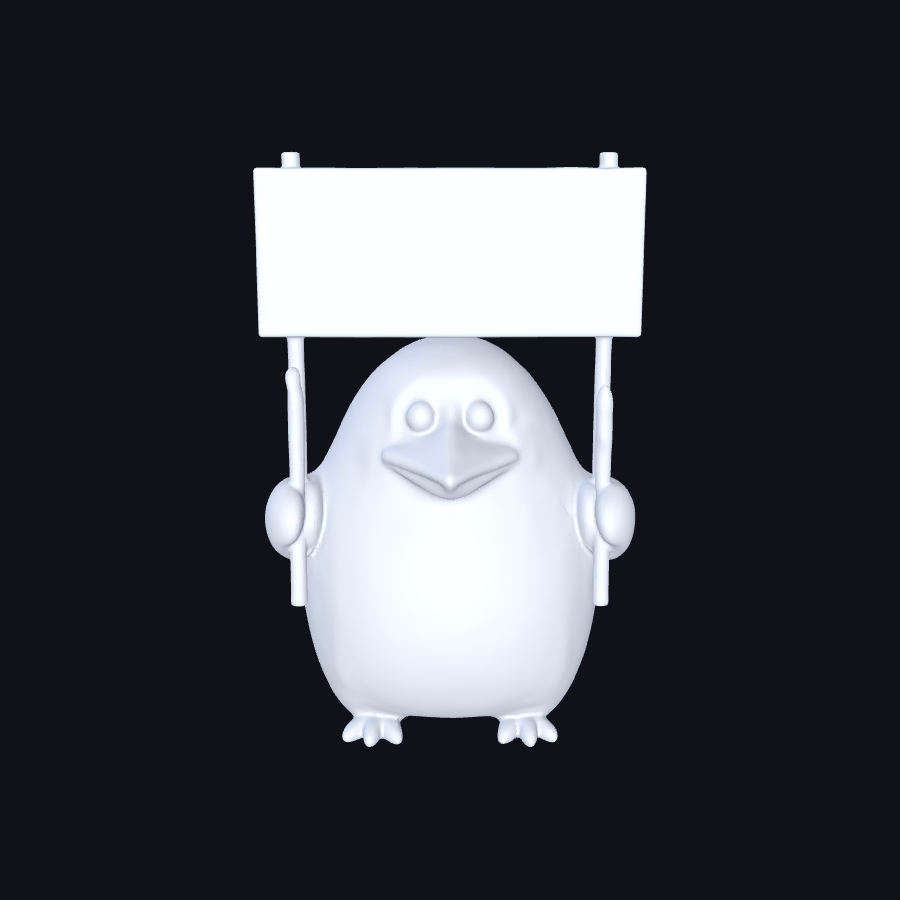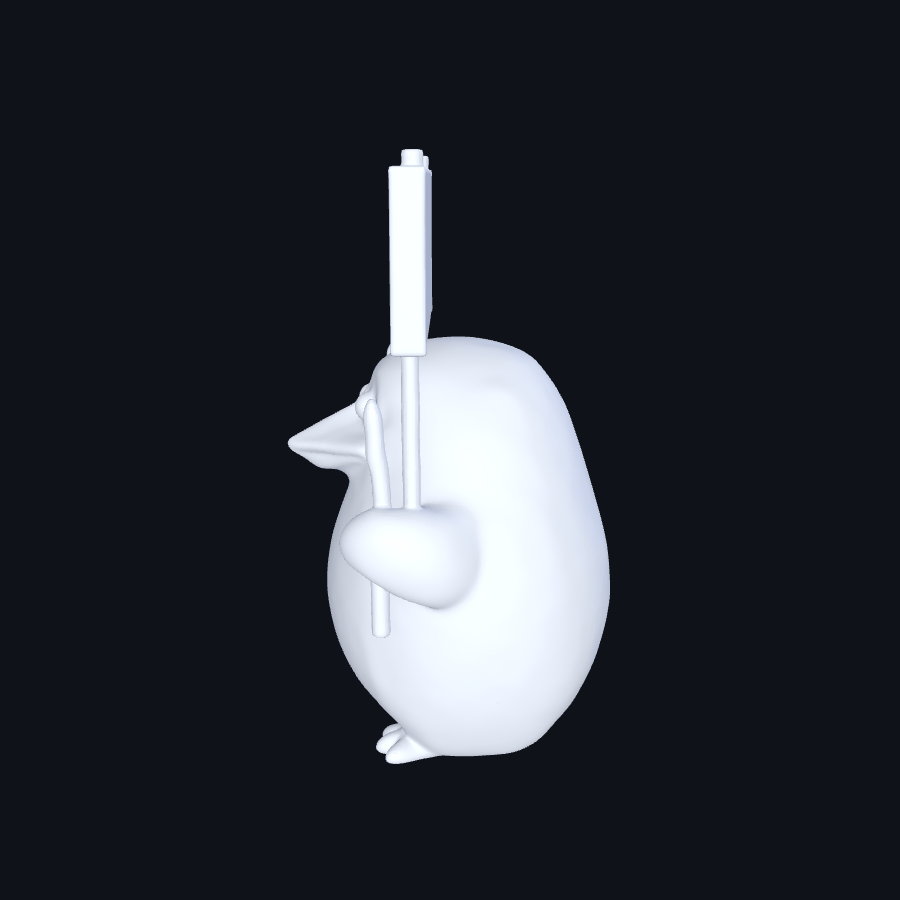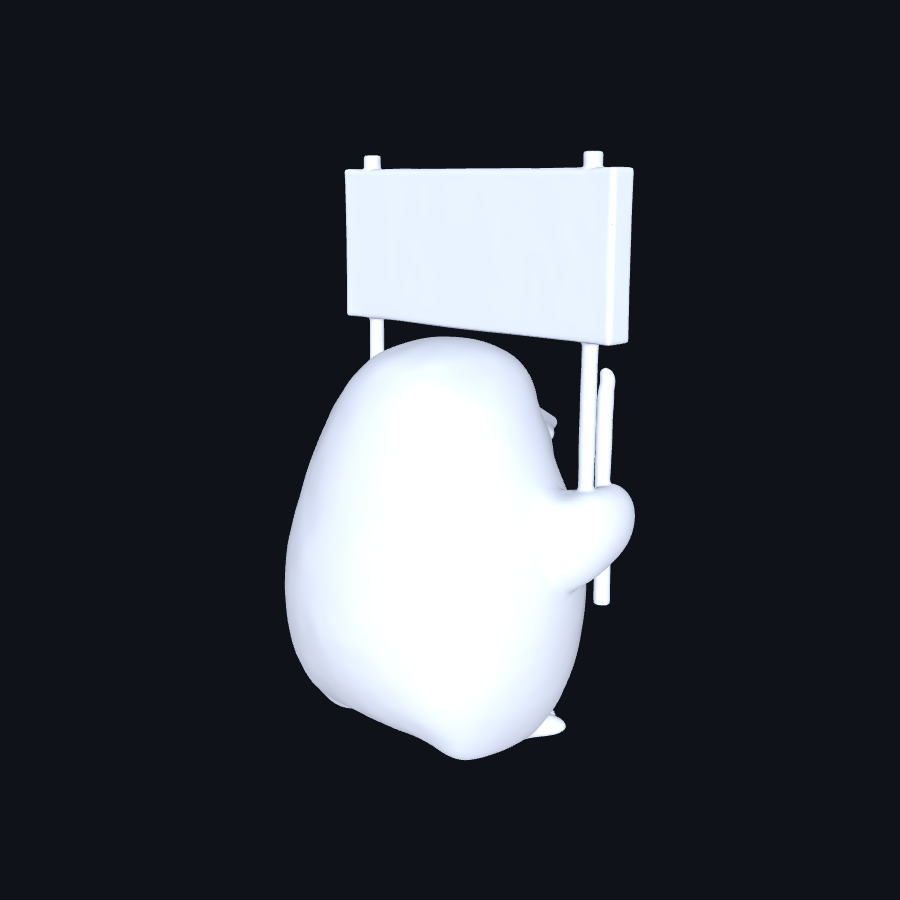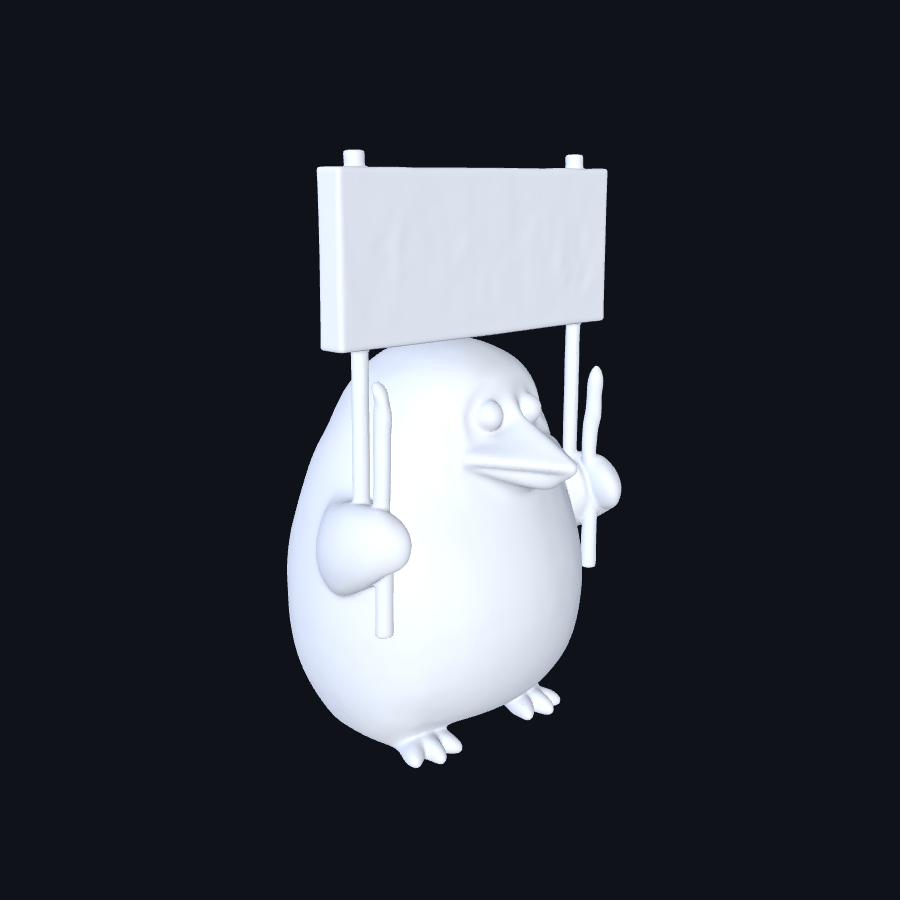
4방향 정지 그리드:
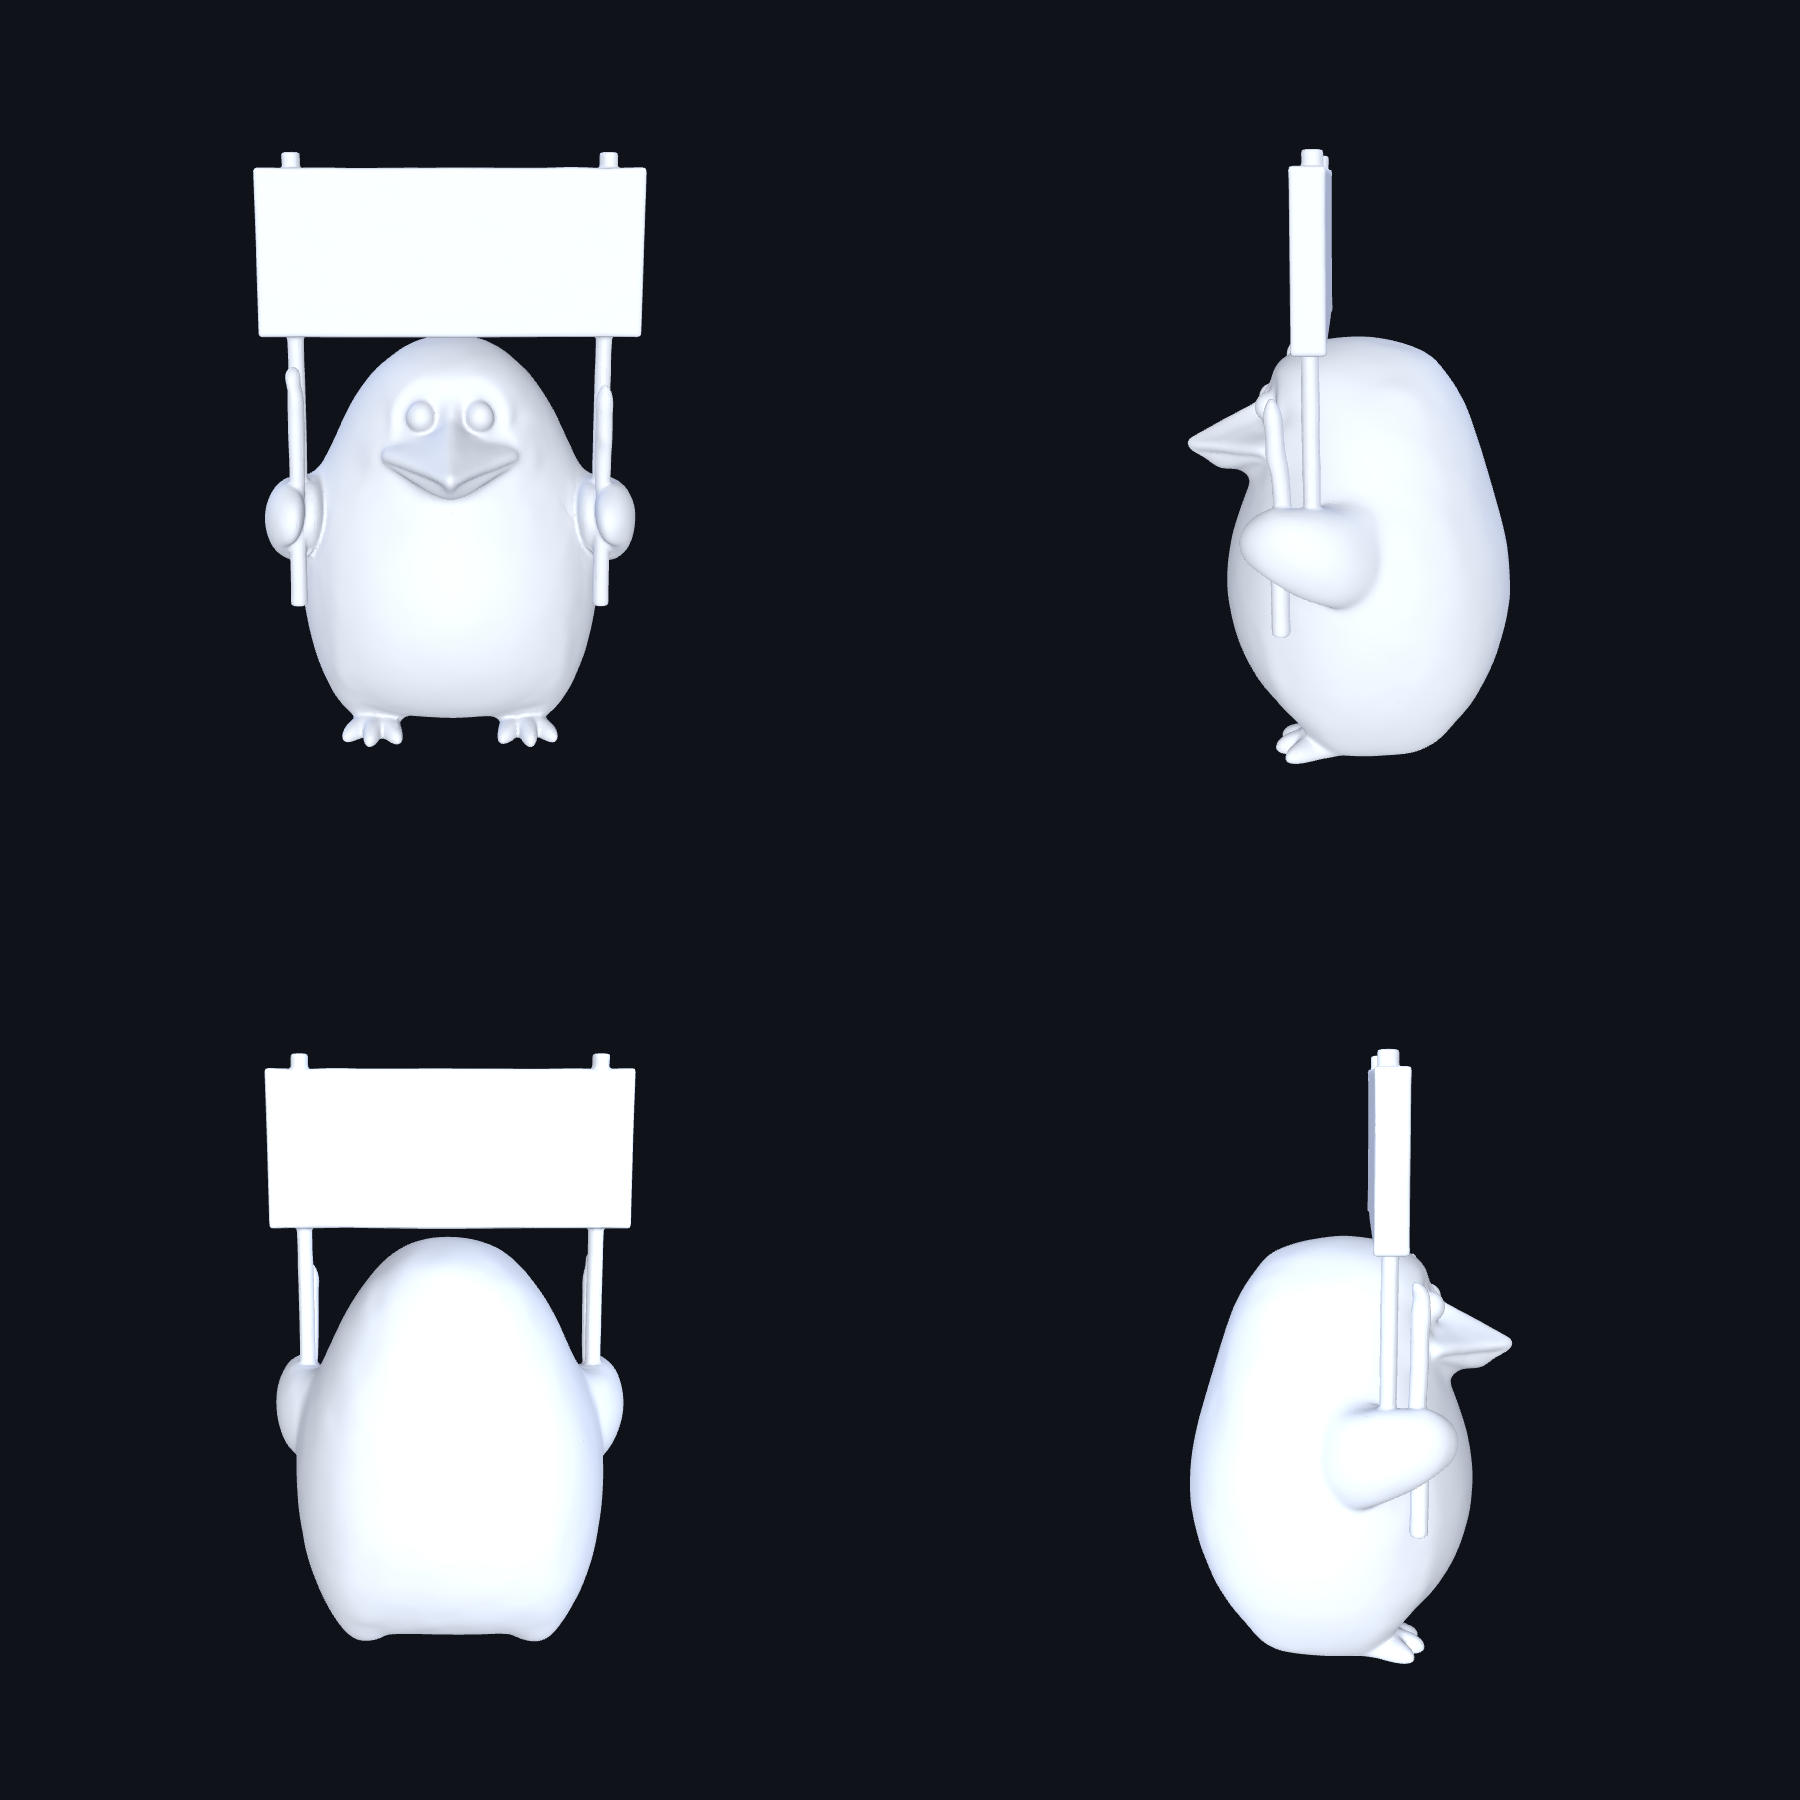
렌더 결과, 표지판·부리·눈·양 팔·발까지 원본 이미지의 디테일이 3D 지오메트리로 정확히 복원된 것을 육안으로 확인할 수 있다. §10의 수치(284,444면, 50.1초, VRAM 5.79GB)가 실제로 쓸만한 품질의 메시를 만들어낸다는 것을 이 렌더가 뒷받침한다. 다음 단계로 실제 MuJoCo 부품(그리퍼 등) 프롬프트를 입력해 활용 사례에 더 가까운 산출물을 생성해보는 것을 제안한다.
13. 팀 공용 API 서비스 설계안 (2026-08-11, v6 추가 — 설계만, 미구현)
지금까지의 검증은 전부 Moojoco가 hb5u에 직접 venv(~/venv/hunyuan3d_test)를 만들어 스크립트로 수동 실행한 것이다. 다른 ROOPS 에이전트(EC2의 Aegis/EOS/Hermes/EROS, RTX 3060의 Recon 등)는 hb5u 셸 접근 권한이 없어 이 방식을 그대로 쓸 수 없다. §10에서 검증된 "형상 전용 생성"(50.1초, VRAM 5.79GB)을 팀 공용 능력으로 만들려면 네트워크 API가 필요하다. 아래는 설계안이며 구현은 별개 작업으로 남긴다.
13-1. 핵심 설계 결정 — 상주(常住) 서비스
모델 로딩 자체가 501.5초(§10) 걸리므로, 요청마다 새로 로드하면 실사용이 불가능하다. systemd 상주 서비스로 모델을 VRAM에 계속 띄워두는 방식을 채택한다 — viz_server.service/mujoco_sim.service/headroom_proxy.service와 동일한 hb5u 기존 패턴을 따른다.
[Unit]
Description=Moojoco Hunyuan3D-2 Shape Generation API (Turbo, shape-only)
After=network.target

[Service]
Type=simple
User=moos
WorkingDirectory=/home/moos/dev_ws/dual_arms
Environment=CUDA_HOME=/usr/local/cuda-13.2
EnvironmentFile=/home/moos/.env_roops
ExecStart=/home/moos/venv/hunyuan3d_test/bin/python3 scripts/hunyuan3d_shape_service.py
Restart=always
RestartSec=5

[Install]
WantedBy=multi-user.target
트레이드오프를 숨기지 않고 명시한다: 상주시키는 순간 8.15GB 카드 중 ~6.2GB(76%)가 서비스 기동 중엔 항상 점유된 상태가 된다. mujoco_sim의 평상시 GPU 사용량은 낮지만(§4-1 기준 유휴 시 ~1.5GB), 향후 더 무거운 GPU 작업이 hb5u에 필요해지면 이 서비스를 일시 중지(systemctl stop)해야 할 수 있다.
13-2. 엔드포인트
GET /health
→ {"status":"ok","model_loaded":true,"vram_used_mb":6220,"vram_total_mb":8151,"queue_depth":0}

POST /generate-shape
Headers: X-Api-Key: <키>
Body: multipart/form-data — image(파일), steps(기본 5), octree_resolution(기본 256), seed(선택)
→ 200 {"status":"ok","glb_url":"https://images.hyperbook.com/hunyuan3d-outputs/<id>.glb",
        "faces":284444,"vertices":142222,"gen_time_s":50.1}
X-Api-Key 인증은 Memory API·RHMS와 동일한 ROOPS 기존 컨벤션을 따른다. 결과물은 images.hyperbook.com의 전용 하위 경로(hunyuan3d-outputs/)에 저장해 URL로 바로 공유 가능하게 한다.
13-3. 동시성 — 큐 1개, GPU 슬롯 1개
§10 측정 기준 모델 상주 후 여유 VRAM은 약 2GB뿐이라 동시 생성은 불가능하다. 서버 내부에 asyncio.Lock(또는 세마포어 1개)으로 요청을 FIFO 직렬화하고, /health의 queue_depth로 대기열 상태를 노출해 호출자가 폭주 여부를 미리 알 수 있게 한다.
13-4. hb5u 리소스 예약 규약과의 통합
hb5u엔 이미 Moojoco·Vorno가 공동 수립한 파일 기반 GPU 예약 규약(/home/moos/.hb5u_resource_locks/)이 있다 — 다만 기존 규약은 "일회성 무거운 작업" 전제로 설계되어, 작업 종료 시 예약 파일을 지우는 방식이다. 이 서비스는 일회성이 아니라 상시 점유이므로 규약을 다음과 같이 확장 적용한다:
- 서비스 기동 시
/home/moos/.hb5u_resource_locks/moojoco-hunyuan3d-shape-service.json을 상시 예약 파일로 생성(expected_duration_min을 매우 크게, 또는 "상주 서비스"임을 명시하는 필드 추가) - 서비스 종료(
systemctl stop) 시에만 파일 삭제 - 다른 에이전트가 무거운 GPU 작업 전 규약대로 이 디렉토리를 확인하면, 이 서비스가 이미 ~6.2GB를 상시 점유 중임을 알 수 있다
13-5. 보안 — Tailscale 바인딩 필수
hb5u에서 과거 두 차례(MySQL, Secondary RHMS) 0.0.0.0 바인딩으로 LAN에 노출된 사고가 있었다(project_hb5u_mysql.md, project_hb5u_rhms_secondary.md). 이 서비스도 반드시 Tailscale IP(100.125.27.70)에만 바인딩하고, --host 0.0.0.0을 쓰지 않는다.
13-6. 요약 표
| 항목 | 설계 값 |
|---|---|
| 배포 방식 | systemd 상주 서비스 (hunyuan3d_shape.service) |
| 모델 | Hunyuan3D-DiT-v2-0-Turbo, 상주 로드(1회 501.5초, 이후 재사용) |
| VRAM 점유 | 상시 ~6.2GB / 8.15GB |
| 동시성 | 큐 1개 직렬 처리 (GPU 슬롯 1개) |
| 인증 | X-Api-Key (ROOPS 기존 컨벤션) |
| 바인딩 | Tailscale IP 전용 |
| 결과 저장 | images.hyperbook.com/hunyuan3d-outputs/ |
| 리소스 조율 | .hb5u_resource_locks/ 상시 예약 파일로 확장 적용 |
| 구현 상태 | 미구현 — 설계만 |