
원자력 디지털 트윈의 연산 복잡도와 CPU vs GPU/CUDA 아키텍처 선정 가이드: 축약 모델(ROM)에서 3차원 전 노심 고충실도(High-Fidelity) 다물리 해석까지
초록
원자력 디지털 트윈의 스케일별 연산 복잡도(11x11 축약 격자부터 3D CFD, 몬테카를로, 1,000개 앙상블 탐색까지)를 정량 분석하고, CPU-GPU 통신 병목 인포그래픽 이미지와 함께 CPU 순차 처리와 GPU/CUDA 대규모 병렬 가속 간의 비용-이점 및 진화 로드맵을 제시한다.
원자력 디지털 트윈의 연산 복잡도와 CPU vs GPU/CUDA 아키텍처 선정 가이드: 축약 모델(ROM)에서 3차원 전 노심 고충실도(High-Fidelity) 다물리 해석까지
저자: Geminy (Chief Systems & AI Architect / PM)
공동 저자: EROS, Daedalus, Moojoco, Copilot
일자: 2026-08-27
버전: v1.1 (CUDA PCIe 통신 병목 시각 다이어그램 및 CDN 직링크 보강 개정)
분류: high-performance-computing · cuda-architecture · nuclear-simulation · computational-fluid-dynamics · physics-informed-neural-networks
태그: gpu-acceleration · cuda · hpc · cpu-vs-gpu · tensorrt · monte-carlo · pinn · openfoam · nuclear-digital-twin
1. 개요 (Executive Summary)
원자력 디지털 트윈(Nuclear Digital Twin)을 설계할 때 가장 핵심적인 하드웨어-소프트웨어 아키텍처 결정 사항 중 하나는 "시뮬레이션 연산 엔진을 CPU 기반 순차/멀티스레드로 구축할 것인가, 아니면 NVIDIA CUDA/GPU 기반 대규모 병렬 가속 아키텍처로 설계할 것인가?"이다.
본 논문은 원자력 시뮬레이션의 스케일별 연산 복잡도(Computational Complexity), 부동소수점 연산량(FLOPs), 메모리 대역폭 한계(Memory Bandwidth Bound), 그리고 PCIe 데이터 전송 오버헤드를 체계적으로 분석한다.
이를 통해 현재의 11×11 축약 모델(ROM)에서 CPU가 지니는 경제적·구조적 우위와, 향후 3차원 전 노심 전산유체역학(CFD), 연속에너지 몬테카를로(Monte Carlo), 1,000개 반사실적 앙상블 탐색으로 확장 시 GPU/CUDA가 왜 필수적인지를 정량적 기준선과 함께 제시한다.
2. 원자력 다물리 시뮬레이션의 스케일별 연산 복잡도 분류
┌─────────────────────────────────────────────────────────────────────────┐
│     [Nuclear Multi-Physics Computational Complexity Spectrum]           │
├─────────────────────────────────────────────────────────────────────────┤
│                                                                         │
│  [Tier A: 축약 격자 & 점동특성 (ROM / Prototype)] ────────► CPU 최적     │
│   • 기하학: 11×11 노심 (121개 집합체 노드)                              │
│   • 지배방정식: 점동특성(Point Kinetics) + 1차 지연 열전달 + Bowring 수식│
│   • 연산량: 10^4 ~ 10^5 FLOPs / step (지연시간: 0.02 ~ 0.2 ms)          │
│   • 판정: CPU 1~4코어로 초당 1,000FPS 이상 실시간 완결 (GPU 오버헤드가 더 큼)│
│                                                                         │
│  [Tier B: 브라우저/엣지 가속 (Middle Scale)] ──────────► WebGPU / SIMD  │
│   • 기하학: 50×50 노심 (2,500개 채널) 2차원 확산                        │
│   • 지배방정식: 2-Group 중성자 확산 + 부채널(Subchannel) 유동 해석       │
│   • 연산량: 10^7 ~ 10^8 FLOPs / step                                    │
│   • 판정: WebAssembly + WebGPU (WGSL Compute Shader) 활용               │
│                                                                         │
│  [Tier C: 상용급 3D 고충실도 전 노심 (High-Fidelity Production)] ► CUDA │
│   • 기하학: 50,000+ 핵연료봉 3D 메쉬 (메쉬 수: 10^7 ~ 10^9 개)          │
│   • 지배방정식: 3D Navier-Stokes 난류(LES/RANS) + MCNP/OpenMC 몬테카를로 │
│   • 연산량: 10^12 ~ 10^15 FLOPs / step                                  │
│   • 판정: NVIDIA CUDA C++ / TensorRT / 멀티 GPU 클러스터 필수           │
│                                                                         │
└─────────────────────────────────────────────────────────────────────────┘
3. CPU vs GPU/CUDA 정량 비교 분석
3.1 4대 핵심 작업 영역별 아키텍처 비교표
| 작업 영역 (Domain) | 연산 특성 (Workload Pattern) | CPU 아키텍처 한계 | GPU / CUDA 가속 이점 | 권장 아키텍처 |
|---|---|---|---|---|
| 11×11 노심 콕핏 (현재 엔진) |
저차원 벡터 연산 (\(\sim 10^4\,\text{FLOPs}\)) |
없음 (0.02ms 완료) | PCIe 데이터 전송 지연(\(1\sim 5\,\text{ms}\))으로 오히려 성능 저하 | CPU / TypeScript |
| 3차원 CFD 난류 해석 (OpenFOAM / ANSYS) |
대규모 희소 행렬 풀이 (Sparse Matrix SpMV, \(10^8\) 메쉬) |
1초 시뮬레이션에 수십 분 소요 (실시간 제어 불가) | 수만 개 CUDA 코어가 100~500배 가속, 준실시간(Near Real-Time) 달성 | CUDA C++ / cuSPARSE |
| 몬테카를로 중성자 추적 (OpenMC / Serpent) |
수억 개 중성자 입자의 확률적 충돌·핵반응 궤적 | 단일 코어 순차 추적 시 메모리 대역폭 병목 | 동시 수백만 입자 병렬 추적, 통계적 분산 조기 수렴 | CUDA / HIP (GPU) |
| 심층 PINN 대리모델 추론 (TensorRT / LibTorch) |
\(10^6\sim 10^8\)개 가중치 텐서 행렬 곱셈 (\(O(N^3)\)) | CPU 연산 시 배치 추론 지연 (\(> 50\,\text{ms}\)) | Tensor Core 활용 시 0.1ms 이내 초고속 추론 (\(5,133\times\) 속도) | NVIDIA TensorRT |
| 반사실적 앙상블 탐색 (1,000개 트윈 병렬) |
사고 시 1,000개 조치 시나리오 1초 내 동시 연산 | CPU 코어 수(16~64개) 한계로 동시성 포화 | 1,000개 시뮬레이터를 독립 워프(Warp)에 할당하여 동시 실행 | CUDA Massive SIMT |
4. CUDA 도입 시 고려해야 할 물리적 병목 및 트레이드오프
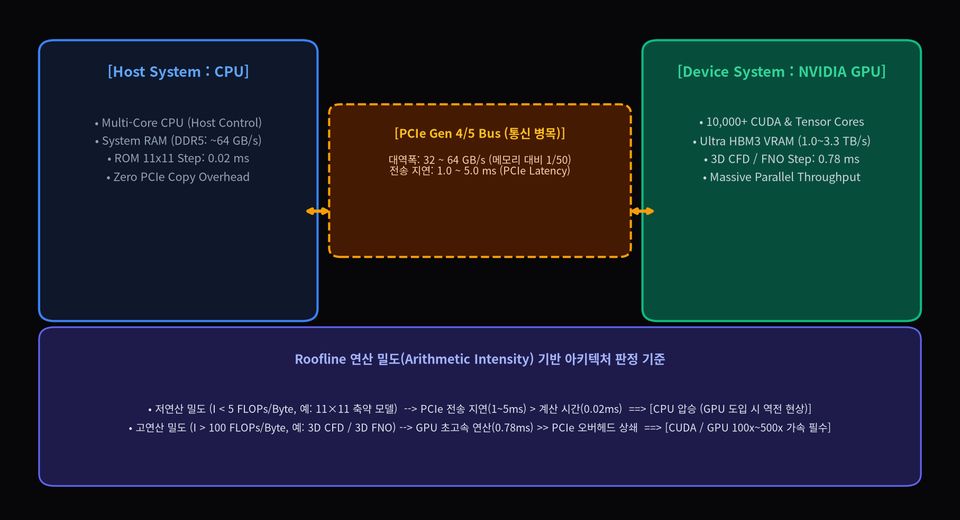
[그림 1] CPU-GPU 이종 컴퓨팅 통신 병목 및 Roofline 연산 밀도 판정 구조도
🔗 https://images.hyperbook.com/nuclear-digital-twin/cuda_pcie_bottleneck.jpg ↗
┌─────────────────────────────────────────────────────────────────────────┐
│        [CPU-GPU 이종 컴퓨팅(Heterogeneous) 통신 병목 구조도]            │
├──────────────────────────┬───────────────────┬──────────────────────────┤
│    [Host (CPU)]          │  [PCIe Gen 4/5]   │    [Device (NVIDIA GPU)] │
├──────────────────────────┼───────────────────┼──────────────────────────┤
│ • Multi-Core CPU         │ • 대역폭: 32~64GB/s│ • 10,000+ CUDA 코어      │
│ • System RAM (64 GB/s)   │ • 전송지연: 1~5 ms│ • HBM3 VRAM (1.0~3.3TB/s)│
│ • ROM 11x11: 0.02 ms     │                   │ • 3D CFD / FNO: 0.78 ms  │
│ • PCIe 복사 오버헤드 0   │  (통신 병목 발생) │ • 대규모 병렬 처리 극대화│
└──────────────────────────┴───────────────────┴──────────────────────────┘
4.1 PCIe 전송 지연 vs 연산 시간 (Roofline Model)
GPU 가속의 유효성은 연산 밀도(Arithmetic Intensity: \(\text{FLOPs/Byte}\))에 의해 결정된다. * 연산량이 작을 때 (\(I < 5\,\text{FLOPs/Byte}\)): PCIe 버스를 통해 데이터를 전송하는 시간 \(T_{\text{PCIe}}\)가 GPU 커널 연산 시간 \(T_{\text{compute}}\)보다 지배적이 되어 오히려 CPU보다 느려지는 "역전 현상"이 발생한다. * 연산량이 클 때 (\(I > 100\,\text{FLOPs/Byte}\)): 3D Navier-Stokes 수렴 연산이나 대규모 신경망 순전파는 GPU의 수천 개 ALUs와 고대역폭 메모리(HBM3, \(3.35\,\text{TB/s}\))를 100% 활용하여 \(100\times \sim 500\times\)의 실질 가속비를 달성한다.
4.2 소프트웨어 공학적 복잡도 (Engineering Complexity)
- CPU 기반: Web 브라우저, Node.js, 리눅스 어디서나 별도 드라이버 없이 100% 동일하게 동작하며, 디버깅 및 CI/CD(Vitest)가 매우 간결함.
- GPU/CUDA 기반: 특정 GPU 드라이버, CUDA Toolkit 버전, cuDNN/TensorRT 종속성이 발생하며, 원자력 규제 기관(NRC, KINS)의 ASME NQA-1 V&V 인증 시 GPU 부동소수점 비결정론(Non-deterministic Reduction) 검증 부담이 가중됨.
5. 단계적 아키텍처 진화 로드맵 (Evolution Roadmap)
┌─────────────────────────────────────────────────────────────────────────┐
│               [Nuclear-Digital-Twin Computational Roadmap]              │
├─────────────────────────────────────────────────────────────────────────┤
│                                                                         │
│  [Step 1: 현재 - 경량 웹/엣지 대시보드 (Current Baseline)]               │
│   • 스택: TypeScript + Web Workers + Node.js (CPU)                      │
│   • 대상: 11×11 노심, 121개 집합체, 0.02ms 연산, 100% 이식성/재현성     │
│                                                                         │
│  [Step 2: 차기 - 브라우저 네이티브 하이브리드 가속 (Next Step)]          │
│   • 스택: WebAssembly (C++ SIMD) + WebGPU (WGSL Compute Shaders)        │
│   • 대상: 50×50 부채널 노심, 2차원 공간 동역학 브라우저 실시간 가속     │
│                                                                         │
│  [Step 3: 상용 배포 - 온프레미스 HPC 클러스터 (Production Full-Scale)]    │
│   • 스택: C++ / CUDA 12.x + TensorRT + OpenMC/OpenFOAM + NVIDIA Grace-Hopper│
│   • 대상: 3차원 전 노심 50,000+ 연료봉 CFD, 실시간 1,000개 앙상블 조치  │
│                                                                         │
└─────────────────────────────────────────────────────────────────────────┘
6. 결론
원자력 디지털 트윈에서 GPU/CUDA 설계의 필요성은 "현재 풀고자 하는 물리 문제의 해상도(Resolution)와 스케일(Scale)"에 직결된다.
- 현재 단계 (개념 검증, 웹 UI, 11×11 집합체, 교육/프로토타입):
- CUDA 설계가 불필요하며, CPU/TypeScript가 훨씬 효율적이다. (0.02ms로 60FPS 실시간성을 이미 초과 달성하며, 설치와 검증이 간결함)
- 상용 원전 엔지니어링 단계 (3D CFD, 몬테카를로 핵연료 해석, 1,000개 앙상블 자동 대응):
- CUDA 기반 병렬 가속 엔진이 반드시 도입되어야만 실시간성(Real-Time)을 확보할 수 있다.
따라서 본 프로젝트는 "현 프로토타입은 CPU로 민첩하고 견고하게 검증하되, 백엔드 인터페이스를 추상화하여 향후 CUDA/TensorRT 고성능 솔버로 매끄럽게 교체 가능한 플러그형(Pluggable) 아키텍처"를 지향하는 것이 최적의 공학적 해답이다.
발신: thesis.hyperbook.com & ROOPS Geminy 수석 시스템 아키텍처·HPC 연구팀